10 min de lecture
PCA et PRA : Comment Scalingo se prépare aux incidents
Quelle est la différence entre un PCA et un PRA, et comment s’assurer qu’ils fonctionneront réellement en cas d’incident ? Découvrez comment Scalingo met sa résilience à l’épreuve à travers des exercices SRE réguliers.

Chez Scalingo, nous parlons régulièrement de Plans de Continuité d’Activité (PCA) et de Plans de Reprise d’Activité (PRA).
Ces acronymes reviennent dans de nombreux contextes : échanges avec nos clients, audits de sécurité, projets d’infrastructure ou encore retours d’expérience après un incident.
Mais à moins de travailler au quotidien avec des équipes SRE ou infra, la différence entre les deux concepts n’est pas toujours évidente. PCA et PRA sont d’ailleurs souvent utilisés, à tort, comme des termes interchangeables
Récemment, Maxime, SRE chez Scalingo, a animé un meet-up interne pour revenir sur ces deux notions : ce qui distingue un PCA d’un PRA, la façon dont ils se complètent et, surtout, comment nous les mettons concrètement en pratique chez Scalingo.
Nous avons donc eu envie de partager les principaux enseignements de cet échange et de vous emmener dans les coulisses de notre plateforme pour voir comment, chez Scalingo, nous préparons et testons notre résilience au quotidien.
PCA et PRA : quelles différences ?
Aucun système n’est à l’abri d’une défaillance. Un serveur peut tomber en panne, une base de données devenir indisponible, des données être supprimées par erreur ou une coupure réseau empêcher soudainement certains services de communiquer entre eux.
La plupart du temps, ces incidents restent limités et sont rapidement résolus. Mais ce n’est pas toujours le cas. Opérer une plateforme cloud, c’est aussi accepter que des incidents se produiront tôt ou tard, et surtout, être prêt à y faire face.
C’est là qu’interviennent le Plan de Continuité d’Activité (PCA) et le Plan de Reprise d’Activité (PRA). Si tous deux visent à renforcer la résilience de l’activité, ils jouent des rôles différents et interviennent de manière complémentaire.
Si vous consultez des ressources en anglais, vous croiserez plutôt les termes BCP (Business Continuity Plan) et DRP (Disaster Recovery Plan), les équivalents anglais de PCA et PRA.
Un Plan de Continuité d’Activité (PCA) vise à maintenir les activités critiques d’une entreprise pendant un incident. Il définit notamment les moyens humains, organisationnels et techniques nécessaires pour maintenir les services essentiels, même en mode dégradé.
Le Plan de Reprise d’Activité (PRA) intervient lorsqu’il faut rétablir la situation après un incident majeur. Il définit comment restaurer les systèmes, l’infrastructure et les données pour revenir à un fonctionnement normal.
Pour résumer : le PCA permet de maintenir l’activité pendant un incident ; le PRA permet de la rétablir :
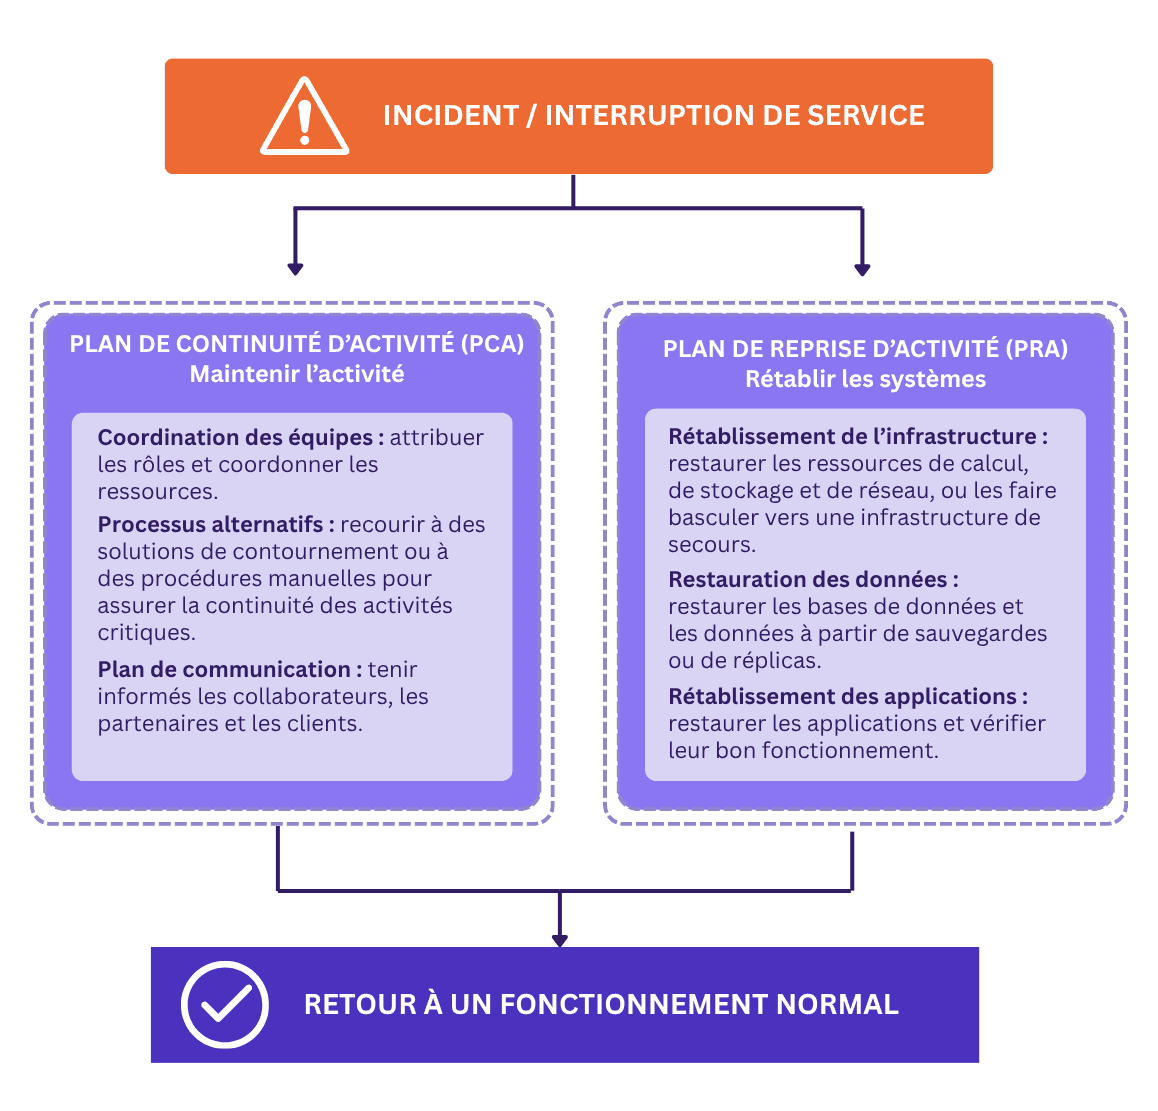
Ensemble, ils permettent de limiter les interruptions de service, de réduire l’impact des incidents et de mieux maîtriser la reprise. Deux approches complémentaires, au service d’un même objectif : permettre à la plateforme de faire face aux défaillances et de retrouver un fonctionnement normal.
C’est ce qu’on appelle la résilience opérationnelle, une notion dont vous nous entendrez souvent parler chez Scalingo.
Chez Scalingo, pour nous assurer que nos dispositifs de résilience sont efficaces et que nos PCA et PRA fonctionnent comme prévu en conditions réelles, nous les testons régulièrement à travers des exercices dédiés
La résilience opérationnelle, c’est la capacité d’une organisation à continuer de fournir ses services critiques malgré les incidents, et à rétablir rapidement la situation lorsqu’ils surviennent.
Pour une plateforme cloud, elle repose à la fois sur des mécanismes techniques (redondance, failover, sauvegardes ou encore reprise automatisée) et sur des pratiques opérationnelles comme la documentation, les exercices réguliers et le partage des connaissances.
L’objectif n’est pas d’éviter tous les incidents, ce qui serait irréaliste, mais de faire en sorte qu’ils aient le moins d’impact possible sur les utilisateurs.
Le PCA chez Scalingo : tester la continuité en conditions réelles
Un plan de continuité peut être parfaitement défini sur le papier. Encore faut-il vérifier qu’il fonctionne lorsqu’un incident survient. C’est tout l’intérêt des exercices de PCA : tester concrètement les procédures, les hypothèses et les mécanismes techniques sur lesquels repose le plan.
Chez Scalingo, nous faisons le choix d’exercices très concrets. Plutôt que de nous limiter à des scénarios théoriques, nos SRE provoquent volontairement des défaillances dans des environnements contrôlés, puis observent la manière dont la plateforme réagit.
Un exercice peut par exemple consister à arrêter une instance d’application, à retirer un nœud d’un cluster ou à simuler la perte d’une partie de l’infrastructure. L’objectif est simple : vérifier que les services critiques continuent de fonctionner, avec peu ou pas d’intervention manuelle.
La façon dont la plateforme résiste à ces défaillances dépend du composant testé. Pour certains services, elle repose sur la redondance et le failover automatique. Pour d’autres, sur des mécanismes de clustering qui leur permettent de continuer à fonctionner même lorsqu’une partie du système devient indisponible.
Nous nous appuyons également de plus en plus sur des boucles de réconciliation, ou control loops. Leur rôle est de comparer en permanence l’état réel de la plateforme à l’état attendu et, lorsqu’un écart apparaît, de le corriger automatiquement. Pour nos utilisateurs, tout cela doit idéalement passer inaperçu.
Chaque scénario est documenté en amont : ce qui est testé, la manière dont la défaillance est provoquée, le comportement attendu et les critères qui permettront de valider l’exercice.
Ces exercices ne servent pas seulement à tester la plateforme. Ils permettent aussi de partager les connaissances opérationnelles au sein de l’équipe et de s’assurer que chacun sait comment réagir face à ce type de situation.
Le PRA : tester notre capacité de reprise
Le Plan de Reprise d’Activité (PRA) prend le relais lorsque les mécanismes de continuité ne suffisent plus.
Certaines défaillances ne peuvent tout simplement pas être compensées par la redondance. Lorsqu’une infrastructure critique est perdue, qu’une sauvegarde doit être restaurée ou qu’un service interne essentiel devient indisponible, l’enjeu n’est plus de maintenir le service, mais de remettre la plateforme en état de fonctionnement.
Les exercices de PRA se concentrent donc sur cette reprise.
Il peut s’agir, par exemple, de restaurer une base de données après une suppression accidentelle, de reconstruire des composants d’infrastructure à partir de zéro ou encore de rétablir des services dont dépendent d’autres éléments de la plateforme. Ces procédures ne restent pas sur le papier : nous les testons régulièrement pour nous assurer qu’elles restent adaptées à mesure que la plateforme évolue.
L’un des scénarios que nous testons est la perte d’un nœud hébergeant des bases de données. Dans ce scénario, les bases de données de nos offres Business basculent vers l’instance secondaire afin d’assurer la continuité de service, tandis que celles des offres Starter restent indisponibles jusqu’à ce qu’un opérateur mène à bien la procédure de reprise d’activité (DRP), qui consiste à redémarrer l’hôte ainsi que les instances qui y sont exécutées. Cet exercice nous permet de vérifier que les basculements attendus s’effectuent correctement et que la procédure de reprise peut être mise en œuvre comme prévu.
L’objectif n’est pas seulement de vérifier que la reprise est techniquement possible. Il s’agit aussi de répondre à des questions très concrètes :
La plateforme peut-elle être rétablie dans les délais prévus ? Les sauvegardes sont-elles complètes et exploitables ? La procédure de reprise est-elle suffisamment documentée ? Un autre ingénieur serait-il capable de l’appliquer sereinement lors d’un incident réel ?
Rejouer régulièrement ces scénarios permet de s’assurer que les procédures de reprise restent à jour et adaptées à la réalité de la plateforme, plutôt que de laisser vieillir une documentation qui n’aurait jamais été testée.
Mesurer la résilience avec le RTO et le RPO
Deux indicateurs sont couramment utilisés pour définir les objectifs de reprise et mesurer leur atteinte : le Recovery Time Objective (RTO) et le Recovery Point Objective (RPO).
Le RTO définit le délai maximal dans lequel un service doit être rétabli après un incident. Ce délai dépend de la criticité du système concerné. Pour les services conçus pour être hautement disponibles, la reprise doit être quasi immédiate grâce au failover automatique. La reconstruction de composants d’infrastructure plus importants peut, en revanche, prendre davantage de temps.
Le RPO répond à une autre question : quelle quantité de données peut-on accepter de perdre ?
Cette notion a un impact direct sur la stratégie de sauvegarde. Si des sauvegardes sont effectuées toutes les heures, par exemple, une restauration peut entraîner la perte des données créées depuis la dernière sauvegarde, soit jusqu’à une heure de données. Le niveau de perte acceptable varie d’un système à l’autre, et définir un RPO permet de s’assurer que la politique de sauvegarde est adaptée aux besoins opérationnels des utilisateurs.
Ensemble, le RTO et le RPO permettent d’évaluer concrètement si les procédures de reprise répondent aux objectifs de résilience définis.
La résilience, c’est aussi une question d’humain
Un point est revenu plusieurs fois lors du meet-up : la résilience opérationnelle n’est pas qu’une affaire de technologie.
Même la meilleure procédure de reprise perd de son utilité si seule une personne sait comment la mettre en œuvre.
C’est pourquoi nous avons beaucoup travaillé ces dernières années à documenter nos scénarios de PCA et de PRA et à les intégrer dans les pratiques quotidiennes de nos équipes.
L’idée est simple : partager les connaissances entre les équipes, faire en sorte que les procédures de reprise soient accessibles à tous et éviter que leur mise en œuvre ne dépende que de quelques personnes.
Chaque exercice est aussi l’occasion de faire évoluer cette documentation. Il permet d’identifier ce qui manque, de préciser certaines étapes ou encore de formaliser des connaissances qui, jusque-là, se transmettaient surtout au sein de l’équipe.
La dimension humaine passe aussi par la communication avec nos utilisateurs. Lorsqu’un incident survient, il faut pouvoir les informer de la situation, de son impact et de son évolution. Nos équipes doivent donc être prêtes à la fois à appliquer les procédures de continuité ou de reprise et à communiquer clairement tout au long de l’incident. Comme pour la réponse technique, cette communication s’appuie sur des processus définis et éprouvés, un sujet à part entière, sur lequel nous reviendrons dans un prochain article.
Contribuer à nos exigences de conformité : ISO 27001, HDS et SecNumCloud
La continuité et la reprise d’activité jouent un rôle important dans des référentiels et certifications comme ISO 27001, la certification HDS (Hébergeur de Données de Santé) ou encore la qualification SecNumCloud de l’ANSSI.
Ces référentiels n’imposent pas nécessairement l’existence de documents portant précisément les noms de PCA et de PRA. Ils demandent en revanche aux organisations de définir des dispositifs adaptés de continuité et de reprise, de les documenter, de les tester régulièrement et de les maintenir dans le temps.
En pratique, formaliser un PCA et un PRA permet de répondre à ces exigences et d’apporter les éléments nécessaires pour démontrer leur mise en œuvre.
Anticiper et se préparer aux incidents
Chez Scalingo, lorsqu’une nouvelle infrastructure ou un nouveau service est mis en place, les SRE travaillent avec les équipes qui le conçoivent pour identifier les composants critiques, anticiper les scénarios de défaillance, définir les objectifs de reprise et évaluer les risques opérationnels. Des questions comme Comment ce service pourrait-il tomber en panne ?, Comment le remettre en service ? ou Qui sait comment l’opérer ? sont posées dès la phase de conception, plutôt qu’une fois le service déployé.
Cette façon de penser guide largement notre approche de l’infrastructure. Chez Scalingo, le PCA et le PRA ne sont pas simplement des plans que l’on rédige pour ensuite les laisser de côté. Ce sont des pratiques d’ingénierie continues qui nous permettent de tester nos hypothèses, d’améliorer la plateforme et de faire circuler les connaissances opérationnelles au sein de l’équipe.
FAQ
Quelle est la différence entre un PCA et un PRA ?
Un Plan de Continuité d’Activité (PCA) vise à maintenir les services critiques disponibles pendant un incident. Un Plan de Reprise d’Activité (PRA) vise à restaurer les systèmes, l’infrastructure et les données après un incident majeur, lorsque les mesures de continuité ne suffisent plus.
Pourquoi tester régulièrement son PCA et son PRA ?
Un plan bien documenté ne suffit pas à garantir la résilience d’une organisation. Des exercices réguliers permettent de vérifier que les mécanismes techniques, les procédures opérationnelles et les processus de reprise fonctionnent comme prévu, tout en permettant aux équipes de rester familières avec leur mise en œuvre.
Que sont le RTO et le RPO ?
Le Recovery Time Objective (RTO) définit le délai dans lequel un service doit être rétabli après un incident. Le Recovery Point Objective (RPO) définit la quantité de données que l’on peut accepter de perdre. Ensemble, ils permettent de définir et de mesurer les objectifs de reprise.
Pourquoi le PCA et le PRA sont-ils importants pour les plateformes cloud ?
Les plateformes cloud reposent sur des systèmes distribués complexes, dans lesquels les défaillances sont inévitables. Le PCA et le PRA permettent de limiter les interruptions de service et les pertes de données, tout en s’assurant que les procédures de reprise ont été testées avant d’avoir à les utiliser lors d’un incident réel.
Le PCA et le PRA sont-ils requis par ISO 27001, HDS ou SecNumCloud ?
La continuité et la reprise d’activité font partie des exigences importantes de référentiels comme ISO 27001, HDS et SecNumCloud. Si les exigences précises varient d’un référentiel à l’autre, les organisations doivent généralement documenter, maintenir et tester régulièrement leurs dispositifs de continuité et de reprise.
Comment Scalingo teste-t-il ses PCA et PRA ?
Chez Scalingo, les PCA et PRA ne sont pas de simples documents figés. Nos équipes SRE réalisent régulièrement des exercices de continuité et de reprise, en documentent les résultats, évaluent des objectifs de reprise comme le RTO et le RPO, et font évoluer les procédures en continu avec la plateforme.

Maxime Caisez
Maxime est un Site Reliability Engineer (SRE), qui contribue à garantir la fiabilité, l'évolutivité et le bon fonctionnement de nos systèmes en coulisses.
Restez informé
Recevez des articles et des mises à jour de la plateforme dans votre boîte de réception.
Prêt à déployer en toute confiance ?
Découvrez des déploiements sans temps d'arrêt, une mise à l'échelle automatique intelligente et une infrastructure entièrement gérée. Commencez à déployer vos applications sur Scalingo dès aujourd'hui.
Aucune carte de crédit requise • Déployez en quelques minutes • Annulez à tout moment