10 min de lecture
Exécuter la stack ELK sur Scalingo
Apprenez à configurer et déployer la stack ELK sur Scalingo PaaS en moins de 5 minutes.

La stack Elastic (anciennement connue sous le nom de stack ELK) est une collection puissante de logiciels qui vous permet de collecter des données de n'importe quelle source utilisant n'importe quel format. Elle vous donne les outils pour rechercher, visualiser et analyser cela en temps réel. Cet article vous montrera comment configurer et déployer cette pile sur le DbaaS Scalingo en moins de 5 minutes.
Cette pile peut couvrir de nombreux cas d'utilisation différents, du suivi des appareils IoT à l'agrégation de données, mais le cas d'utilisation le plus connu de ces outils est de parser, stocker, indexer, rechercher et visualiser des journaux provenant de nombreuses sources différentes.
Qu'est-ce que la stack ELK ?
La pile ELK est basée sur trois composants majeurs :
Elasticsearch
Logstash
Kibana
Elasticsearch est un moteur de recherche distribué en texte intégral, capable de stocker des documents JSON et de les indexer efficacement, il est responsable du stockage de toutes les données entrantes.
Logstash est un pipeline de traitement de données, toute source envoie des données en entrée. Il est capable de formater et de modifier les données à la volée avant de les transmettre à la destination choisie (généralement une base de données Elasticsearch).
Kibana est un puissant outil de visualisation de données basé sur le web fournissant tout ce dont vous avez besoin pour explorer vos données et créer des tableaux de bord utiles et efficaces.
Logstash
Commençons par initialiser le conteneur Logstash. Cette instance prendra ses données d'une entrée authentifiée et les enverra à une base de données Elasticsearch. C'est la partie EL dans ELK.
Heureusement, notre puissant John a écrit un joli modèle de Logstash pour vous aider à démarrer. Ce dépôt contient différents exemples de configuration et les fichiers requis pour le déploiement.
Ensuite, créez une application sur Scalingo qui exécutera notre application Logstash :
Ajoutez le module complémentaire Elasticsearch à cette application :
Tous les plans Elasticsearch sont décrits ici.
Bien sûr, tout le monde ne devrait pas pouvoir envoyer des données à votre instance Logstash, elle doit être protégée via l'authentification HTTP de base. Cela est déjà géré dans le modèle, mais les variables d'environnement USER et PASSWORD doivent d'abord être définies.
Modifiez le fichier logstash.conf pour changer le nom de l'index de la sortie Elasticsearch. L'objectif est de le rendre sémantiquement adapté aux données qui seront stockées :
Engagez vos modifications
Et c'est tout, il suffit de git push scalingo master et votre instance Logstash sera opérationnelle !
Vous pouvez maintenant essayer d'envoyer des données à votre instance Logstash :
Il est temps de vérifier tous les index qui sont stockés dans la base de données Elasticsearch :
Logstash a créé l'index unicorn qui peut maintenant être demandé :
Le résultat de la recherche ci-dessus contient un document ayant un champ name défini sur Alenala et un champ message défini sur Salut!.
Anatomie du modèle de Logstash
Pour obtenir le résultat précédent, le modèle est structuré autour de trois fichiers différents :
Le premier est le .buildpacks. Ce fichier définit comment cette application doit être construite. Dans ce cas, Java doit être installé en premier, puis le buildpack officiel de Logstash de Scalingo doit être exécuté pour installer Logstash.
Plus d'informations sur la fonctionnalité multi-buildpack peuvent être trouvées dans notre documentation.
Le second est le Procfile qui définit la commande pour démarrer l'application.
Ce Procfile définit que le conteneur web (par défaut) invoquera le démon Logstash, donc toutes les options de ligne de commande acceptées par l'agent Logstash peuvent être utilisées.
Le modèle utilise uniquement le drapeau -f qui spécifie le chemin vers le fichier de configuration.
Enfin, le logstash.conf définit le pipeline de Logstash.
Dans ce cas, ce fichier est assez simple, décomposons-le :
La première section est la section d'entrée, utilisant le plugin http-input qui créera un serveur HTTP écoutant sur le port $PORT et qui n'acceptera que les connexions authentifiées.
La section suivante est le bloc filter, c'est généralement ici que toute la magie se produit.
Ce premier filtre appliqué invoque le plugin grok pour obtenir tous les paramètres URI et les stocker dans le champ url. Cela se fait en appliquant le modèle URIPARAM à l'en-tête request_uri. Ensuite, le plugin grok rejettera tous les en-têtes puisqu'ils ne sont plus nécessaires.
[Cet outil](http://grokdebug.herokuapp.com/) est génial pour créer et déboguer des correlateurs grok.
Dans l'exemple précédent, il y aurait un champ url contenant :
Le deuxième filtre utilisé est le plugin kv pour analyser la chaîne ci-dessus et définir les champs correspondants.
Après tout le pipeline, le document indexé ressemblera à :
La dernière section est la sortie. La configuration concernant la destination des données générées est définie ici. Dans le modèle, la cible est une base de données Elasticsearch.
Le plugin Elasticsearch est utilisé pour y parvenir.
Les variables d'environnement `ELASTICSEARCH_USER`, `ELASTICSEARCH_PASSWORD` et `ELASTICSEARCH_HOST` sont définies par un [wrapper](https://github.com/Scalingo/logstash-buildpack/blob/master/bin/logstash) défini dans notre [buildpack Logstash](https://github.com/Scalingo/logstash-buildpack) qui les déduira de la variable d'environnement `ELASTICSEARCH_URL` de l'application.
Cette configuration est assez incroyable mais pas vraiment utile dans la vie réelle. Ce serait bien d'envoyer des données structurées au serveur Logstash et de définir plusieurs champs. Voici venir les filtres. Nous allons couvrir 2 types de filtres : JSON et Key/Value.
Filtre JSON
Les données envoyées à logstash peuvent être encodées en JSON. Pour les analyser, le pipeline de filtre doit être légèrement modifié, en ajoutant le plugin de filtre JSON :
L'attribut source du plugin de filtre JSON indique quel champ sera interprété comme une chaîne JSON.
Filtre Key/Value
Une autre méthode est d'utiliser des journaux au format clé-valeur. Ces types de chaînes sont souvent utilisés dans les journaux d'application puisque ce format peut être facilement lu par des ordinateurs et par des humains. Ce format ressemble à :
Pour analyser ce genre de journaux, le plugin de filtre KV peut être utilisé.
Par défaut, ce plugin fonctionne sur le champ message, donc la section de configuration dans le fichier logstash.conf est minimale :
Mais pour éviter que des clés importantes ne soient écrasées, ajouter un préfixe aux clés générées par le filtre kv est recommandé :
Kibana
Pour déployer Kibana sur Scalingo, vous êtes invités à utiliser notre bouton de déploiement en un clic juste ici :

La variable d'environnement ELASTICSEARCH_URL de l'application Logstash précédemment créée doit être utilisée dans le processus de déploiement :
Ensuite, un nom d'utilisateur et un mot de passe doivent être définis pour configurer l'authentification de Kibana.
Une fois déployé, les motifs d'index doivent être configurés. Cela est requis pour informer Kibana sur les index d'Elasticsearch qu'il doit examiner.
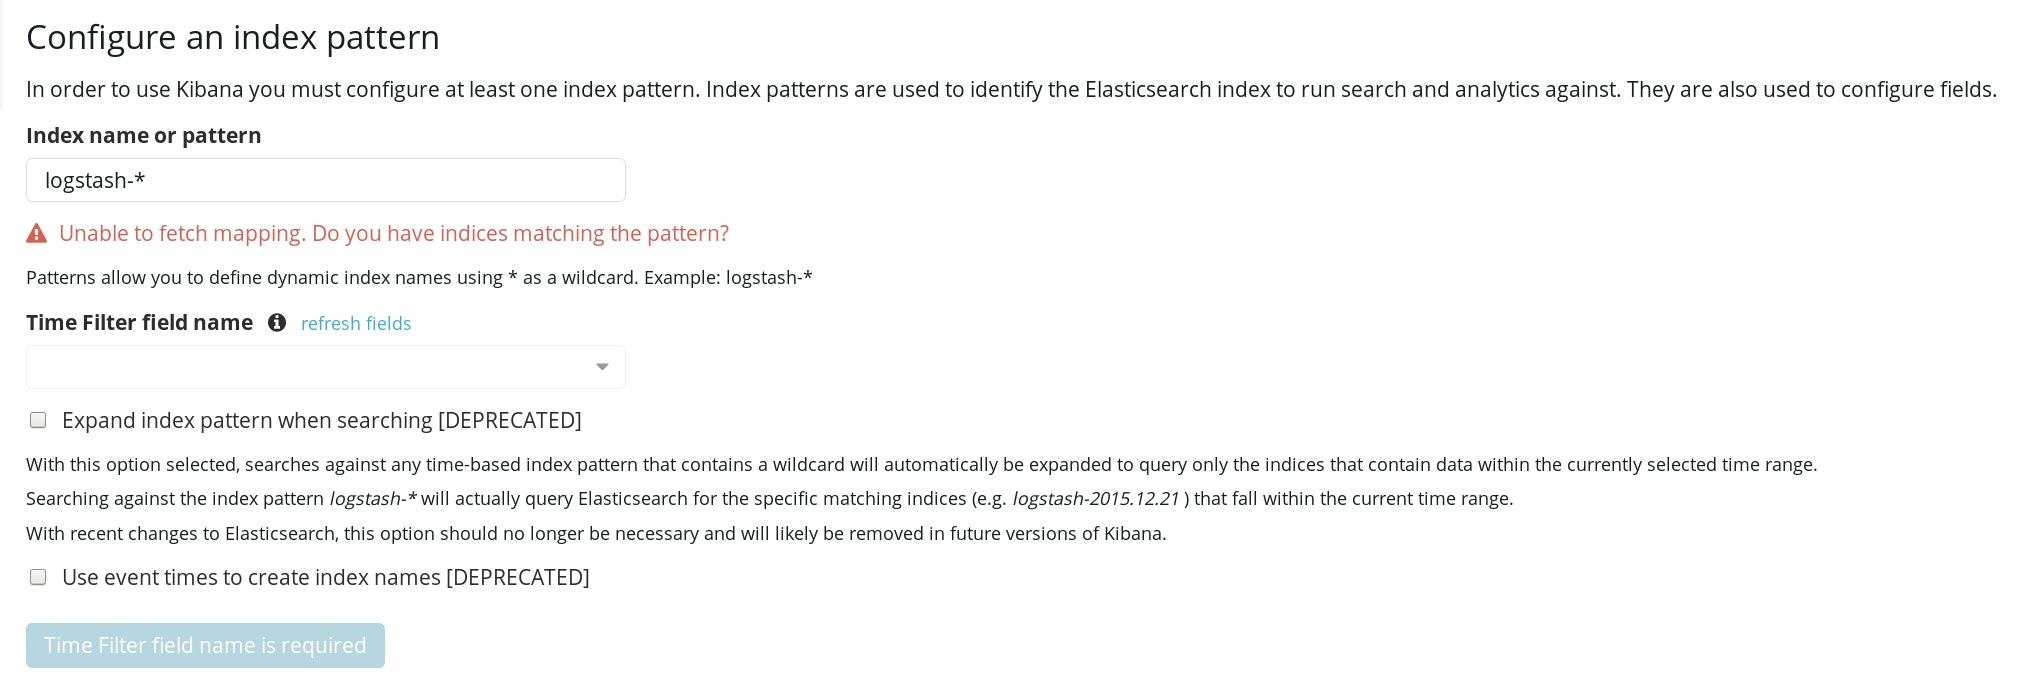
Dans cet exemple, le motif unicorns-* sera utilisé.
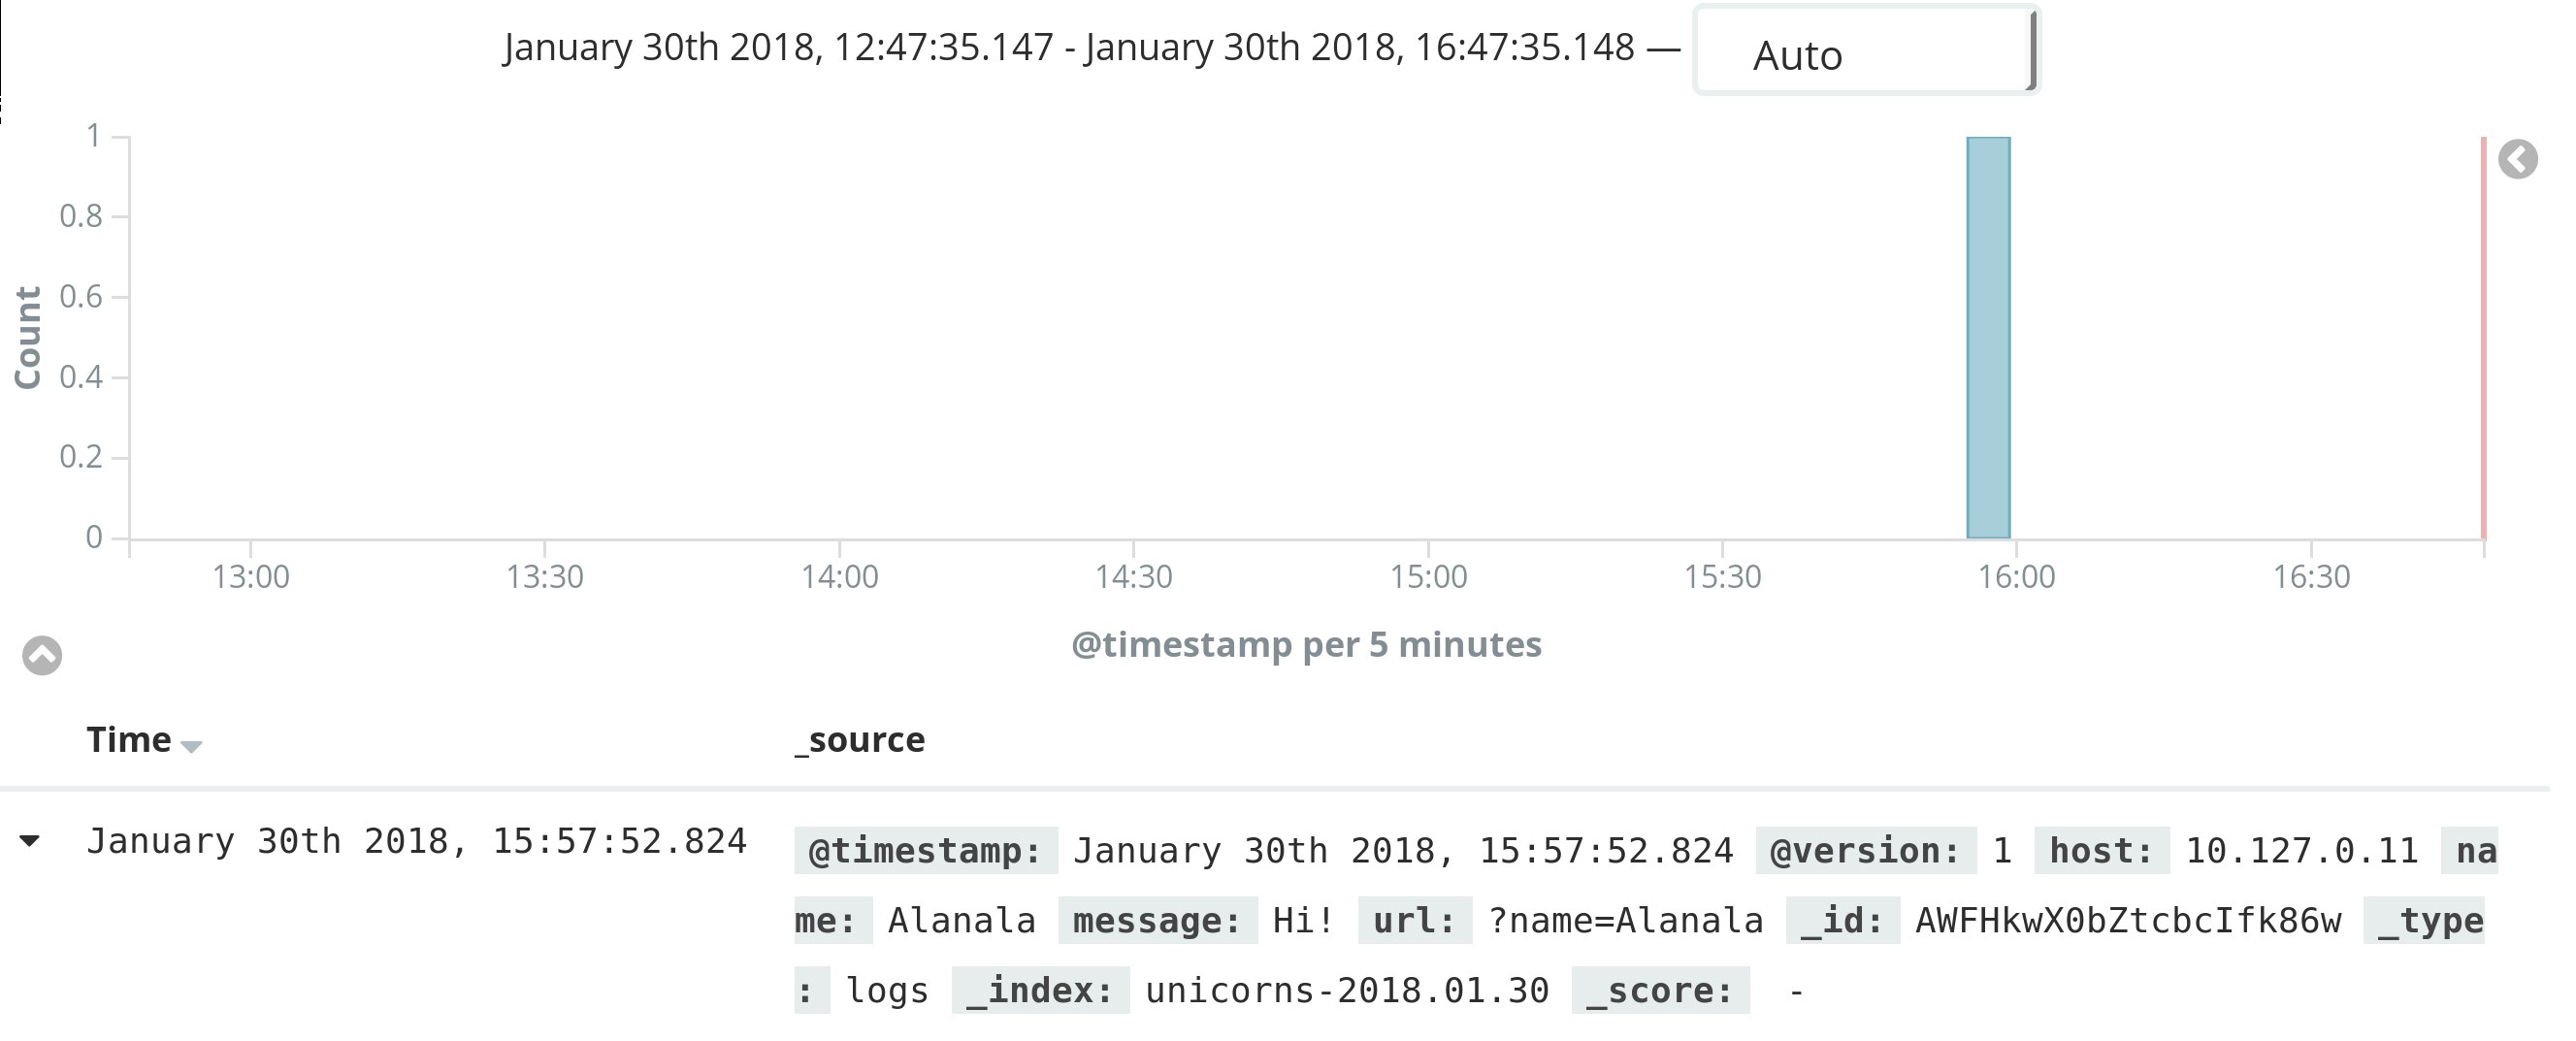
Cliquez sur créer et vous êtes prêt, l'entrée de test effectuée dans la section précédente devrait apparaître dans l'onglet Découverte du tableau de bord de Kibana.
Envoyez les journaux de votre application à votre propre stack ELK
L'un des multiples usages de la stack ELK est le parsing, le stockage et l'exploration des journaux. Si vous avez configuré votre stack ELK pour cela, nous avons une fonctionnalité bêta appelée LOG DRAINS qui enverra automatiquement chaque ligne de journal générée par une application à une stack ELK. Si vous êtes intéressé par ce type de fonctionnalité, contactez simplement l'équipe de Scalingo via le support en chat ou par e-mail à support@scalingo.com.
Journaux sur Scalingo
En interne chez Scalingo, nous utilisons cette stack exact depuis plus de 6 mois pour le parsing et l'indexation des journaux de la plateforme. Cette stack nous a aidés à déboguer les choses beaucoup plus rapidement que nous ne pouvions auparavant et même à détecter des problèmes avant qu'ils n'impactent l'environnement de production.
Cependant, aussi cool que soit cette pile, elle n'est pas suffisante pour pouvoir avoir un rapport significatif à partir de vos journaux, vous devez enregistrer de manière significative. C'est pourquoi l'ajout de cette stack a été suivi de nombreux refactoring et réflexions sur la façon dont les choses devraient être journalisées. Notre CTO a fait une présentation sur la façon dont nous avons réussi à avoir des journaux significatifs dans un environnement de microservices lors du meetup ParisAPI (vidéo et diapos). Nous avons également publié notre bibliothèque de journalisation extensible basée sur le contexte dans notre dépôt go-utils.
Mots de la fin
Enfin, lors de cette présentation, nous n'avons montré qu'un exemple utilisant le plugin d'entrée HTTP. Cependant, si vous souhaitez utiliser beats, vous devez être capable d'ouvrir des connexions TCP brutes à votre application. Cela est désormais possible avec Scalingo en utilisant notre module complémentaire TCP.
Photo de couverture par [Marek Mucha](https://unsplash.com/photos/6ZOyOk5v_PM) sur [Unsplash](https://unsplash.com/)

Jonathan Hurter
Jonathan était l'un des premiers développeurs de Scalingo et il fait partie de l'entreprise depuis 2016. Autant vous dire qu'il connaît bien la plateforme Scalingo. En parallèle, il est également actif dans la scène associative strabourgeoise. Lorsqu'il a un peu de temps, il rédige des articles sur ce blog.
Restez informé
Recevez des articles et des mises à jour de la plateforme dans votre boîte de réception.
Prêt à déployer en toute confiance ?
Découvrez des déploiements sans temps d'arrêt, une mise à l'échelle automatique intelligente et une infrastructure entièrement gérée. Commencez à déployer vos applications sur Scalingo dès aujourd'hui.
Aucune carte de crédit requise • Déployez en quelques minutes • Annulez à tout moment